
同样一份 10 万 token 的公司资料,连着问 10 个问题,账单可能是 3 美元,也可能是 0.645 美元。差的不是模型,也不是谁的提示词写得更漂亮,而是同一份资料有没有被反复重复计算——也就是 KV 缓存到底有没有命中。
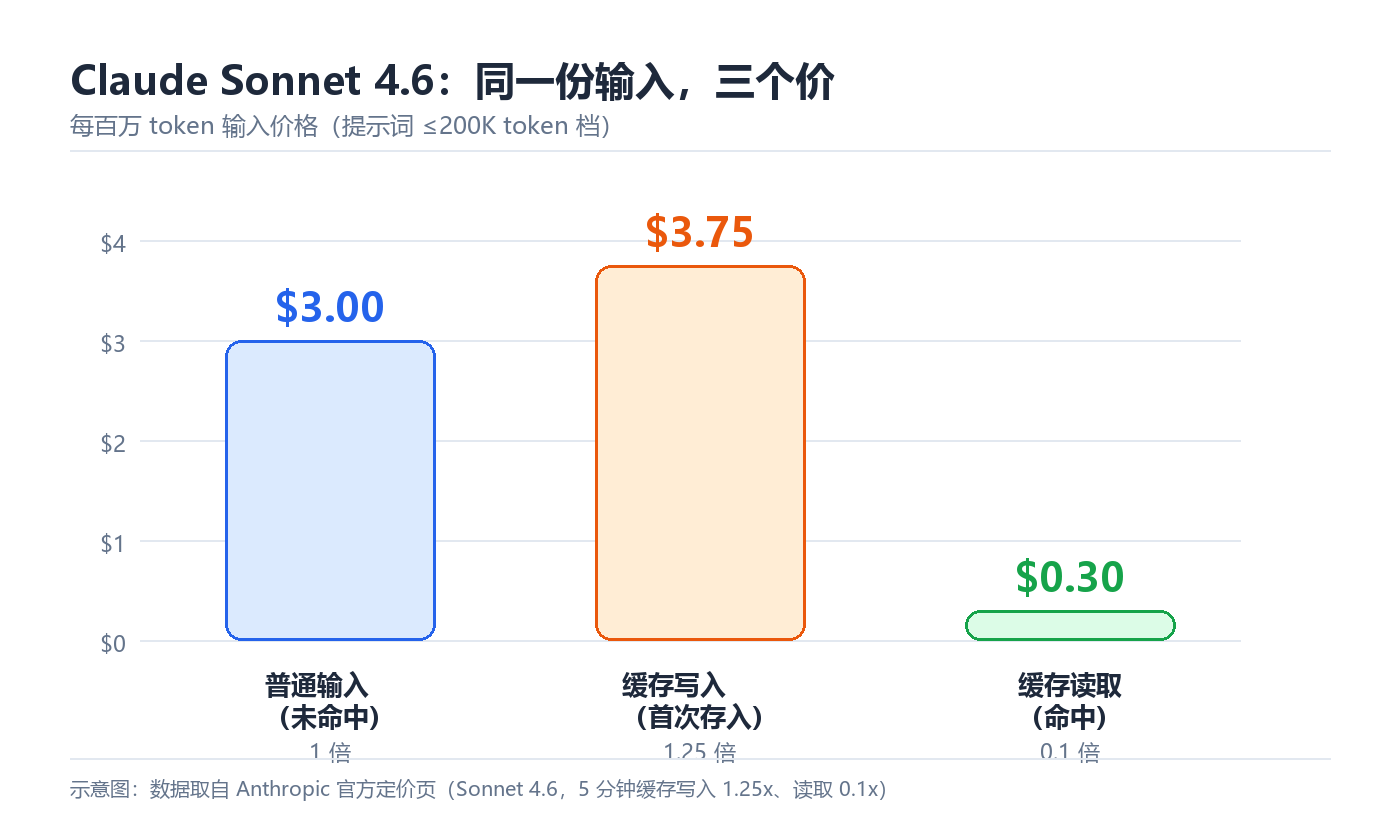
图 1:Sonnet 4.6 的三档输入价格(提示词 ≤200K token 档)。示意图,数据源为 Anthropic 官方定价页。
一、KV缓存是什么:AI读资料时打的计算底稿
模型读输入时,要把每个 token 都换算成一组 Key 和 Value,后面的 token 必须借助前面这些 KV 才能算出注意力结果。KV 缓存就是这份中间计算结果,它决定了两件事:
- 只认前缀:只要开头部分一模一样,算出来的 KV 就完全相同,可以存起来下次直接用。
- 改一处废一片:前缀里任何位置变动,从那个位置往后的 KV 全部作废,必须重算。
所以缓存命中的判定标准极其死板——精确前缀匹配,一个 token 都不能差。这也直接给出了用缓存的第一原则:不变的东西放前面,每次都变的东西往后放。
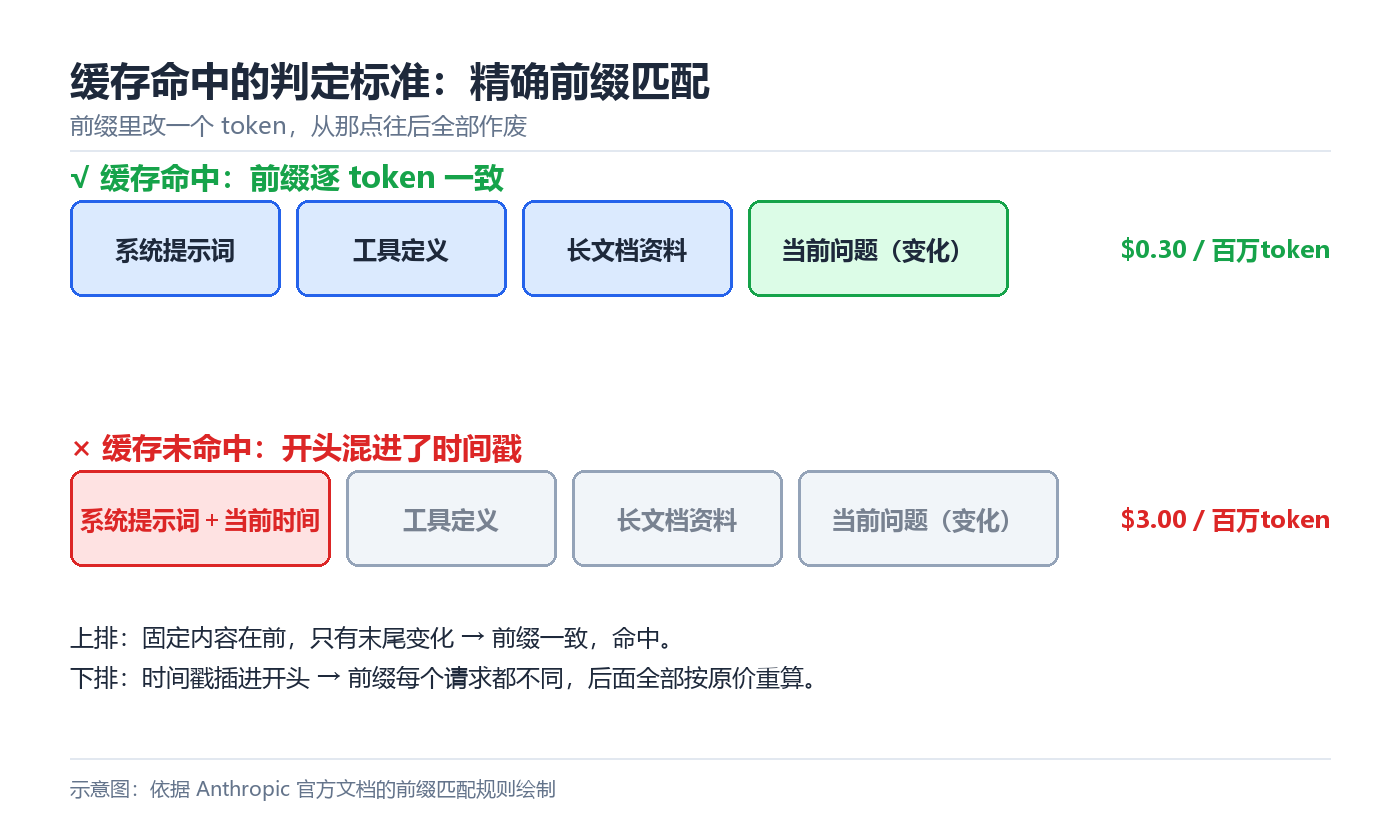
图 2:命中与未命中的分水岭在于前缀是否逐 token 一致。示意图,依据官方前缀匹配规则绘制。
二、价格差在哪:同一份输入,三个价
以 Claude Sonnet 4.6 为例,提示词在 200K token 以内时,每百万 token 的输入价格分三档:
| 输入类型 | 每百万 token | 与基础输入价的关系 |
|---|---|---|
| 普通输入(未命中) | 3.00 美元 | 1 倍 |
| 缓存写入 | 3.75 美元 | 1.25 倍 |
| 缓存读取(命中) | 0.30 美元 | 0.1 倍 |
这三档背后是 Anthropic 公开的计费倍率,换成倍数更好记:
- 5 分钟缓存写入:基础输入价的 1.25 倍($3.75)。
- 1 小时缓存写入:基础输入价的 2 倍($6.00)。
- 缓存读取(命中):基础输入价的 0.1 倍($0.30),也就是一折。
写入比原价贵,是因为第一次要额外付一份「存起来」的成本;但只要读一次就回本了。
三、算笔账:10万token资料,连问10个问题
一份 10 万 token 的公司资料,连续问 10 个问题,两种走法的账单如下:
| 方案 | 计算过程 | 总费用 |
|---|---|---|
| 完全不缓存 | 0.1M × 3 美元 × 10 次 | 3.000 美元 |
| 5 分钟缓存 | 首次写入 0.1M × 3.75 美元 = 0.375;后 9 次读取 0.1M × 0.3 美元 = 0.27 | 0.645 美元 |
结论:3 美元降到 0.645 美元,省掉约 78.5%。
回本点在第二次就出现了:不缓存连问两次是 1+1=2 倍,走 5 分钟缓存是 1.25+0.1=1.35 倍,第一次写入多付的那 25% 在第二轮就被摊平。哪怕 10 个问题拖到 10 分钟才问完(5 分钟 TTL 过期需要重写一次),成本也只有 0.375×2 + 0.03×8 = 0.99 美元,仍是不缓存的三分之一。
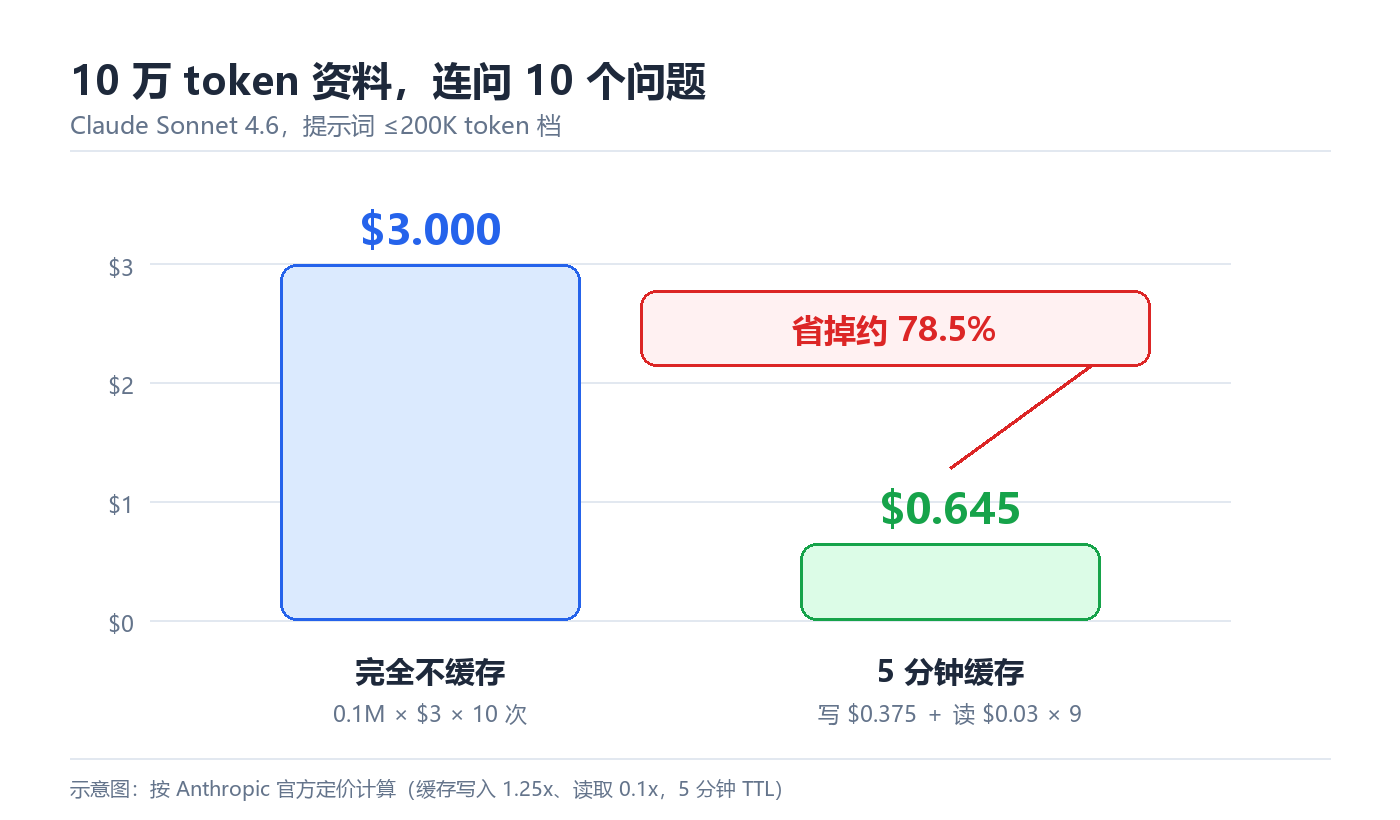
图 3:资料越长、问题越多,缓存带来的差距越大。示意图,按官方定价计算。
四、为什么做 Agent 的团队特别在意
Agent 的工作方式和单次问答完全不同,它要反复带着同一堆材料往前走:
- 查网页、读文件、调用工具,每一步都要叫一次模型。
- 上一轮拿到的材料,下一轮还得原样带上,否则模型就断了上下文。
- 一轮任务动辄十几到几十次调用,每次的输入都包含大段重复内容。
这就把缓存命中率放大成了成本的主开关:命中好,旧材料每轮都按 0.1 倍读;命中差,同一段历史每轮都按 1 倍重付一遍。
按一个 20 轮、每轮上下文约 5 万 token 的 Agent 任务粗算(假设每轮 90% 内容命中):
- 不缓存:20 × 0.05M × 3 美元 = 3.00 美元。
- 开启缓存:首轮写入 0.05M × 3.75 = 0.1875 美元,之后 19 轮每轮「4.5 万命中 + 0.5 万新增」约 0.0285 美元,合计约 0.73 美元。
省下的七成多,在多轮工具调用里还会继续放大——这就是 Agent 团队把命中率当核心指标监控的原因。
五、怎么让缓存更容易命中
一句话原则:固定内容放前面,变化内容往后加。 具体落实为三条:
5.1 开头要稳定
- 系统提示词、工具说明不要每次重新拼装,工具定义要保持稳定的顺序,别让框架动态排序。
- 当前时间、用户名、会话 ID 这类每轮都变的内容,放到固定内容之后,不要塞进系统提示词。
- 模板里的日期、版本号会变,就单独挪到末尾,别跟固定说明混在一起。
5.2 新结果往后追加
- 历史的动作与工具返回保持原样,只追加、不重排、不回插。
- 不要中途把历史消息压缩成摘要再拼回去——前缀一变,前面攒的缓存整段作废。
- 对话变长后要注意:官方的自动回溯只在约 20 个内容块范围内能找到上一次的写入点,长任务应该在靠近当前位置再补一个断点。
5.3 确认缓存真的开了
- 自动缓存:在请求顶层加一个 cache_control 字段,系统自己管理断点,多数场景够用。
- 显式断点:最多 4 个,打在不同变化频率的内容后面(工具定义、长文档、对话历史),断点本身不收费。
- 核对 usage:响应里的 cache_creation_input_tokens 是写入量、cache_read_input_tokens 是命中量;两个都是 0 就说明压根没缓存上,最常见的原因是没到最小长度。
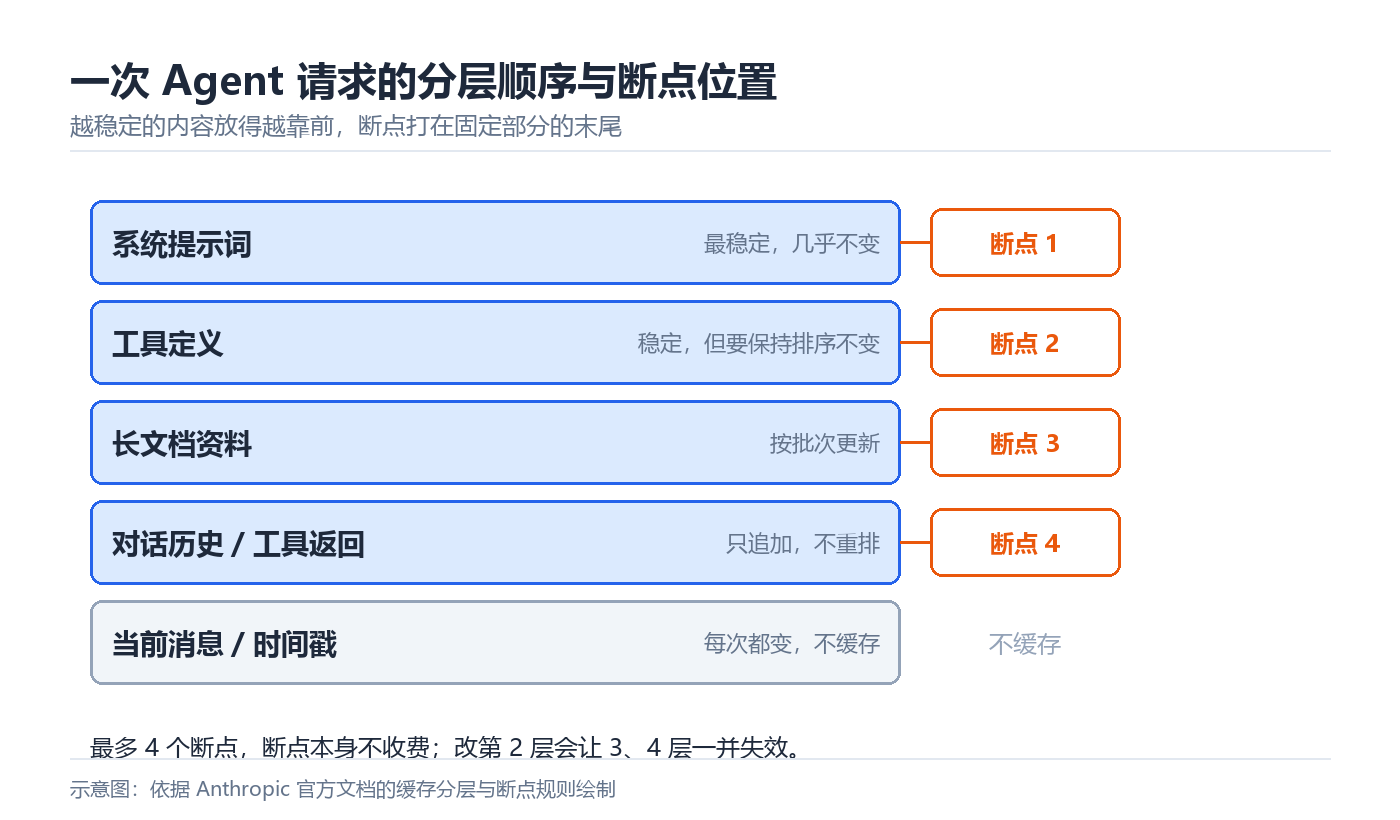
图 4:越稳定的内容放得越靠前,断点打在固定部分的末尾。示意图,依据官方断点规则绘制。
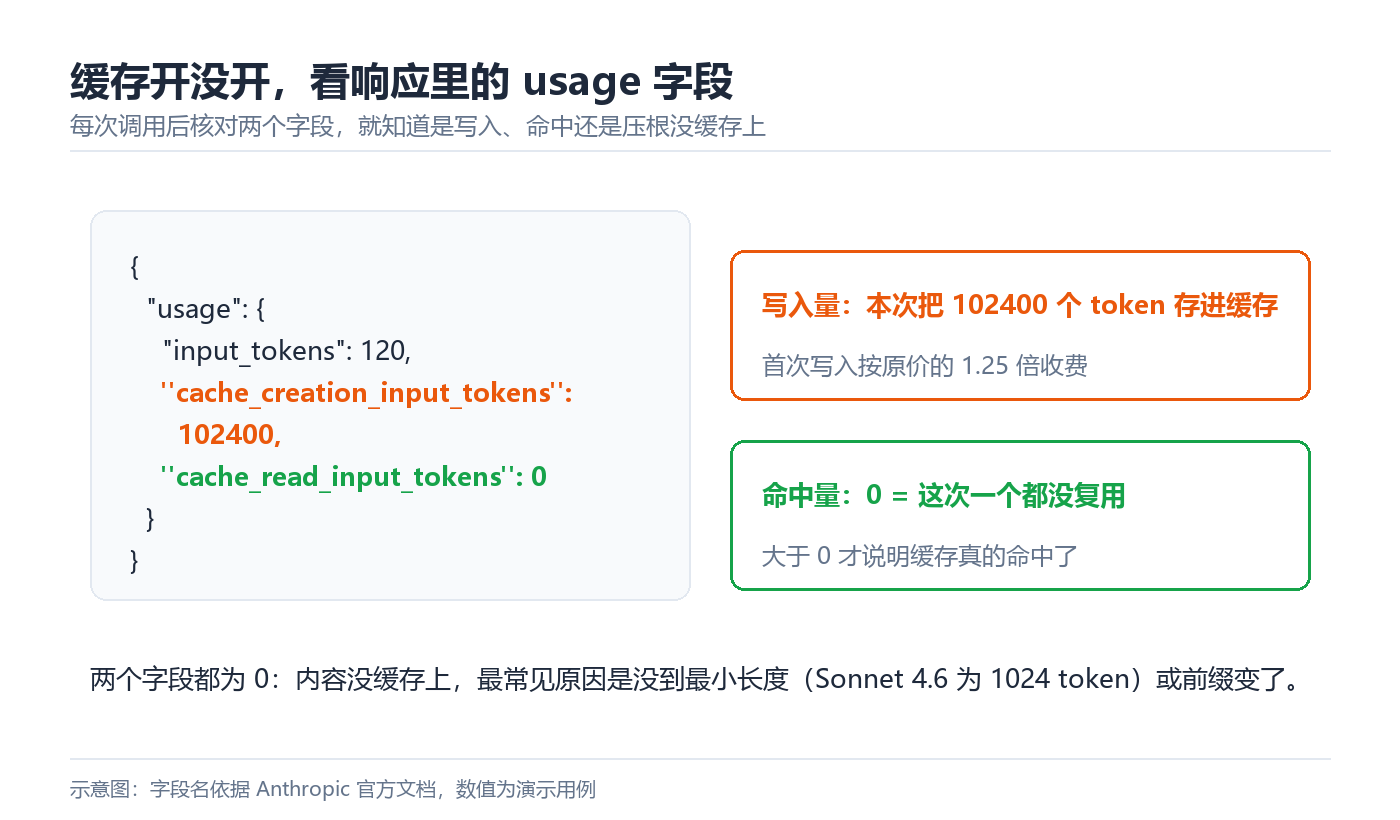
图 5:每次调用后看一眼 usage 字段,就知道缓存是写入、命中还是压根没开。示意图。
六、几个容易被忽略的坑
- 太短不缓存:Sonnet 4.6 与 Opus 4.8 的最小可缓存长度是 1024 token,Haiku 4.5 是 4096 token;不够长不会报错,只是按普通输入原价收费。
- 并发打不中:缓存条目要等第一个响应开始生成之后才可用,一批并发请求之间拿不到彼此的缓存,想要命中就得等首响再发后续。
- 5 分钟有效期:默认 TTL 只有 5 分钟,间隔超了就得按 1.25 倍重写;低频场景可选 1 小时 TTL(写入 2 倍),但至少读两次才划算。
- 长提示另算价:提示词超过 200K token 的档位更贵,Sonnet 4.6 为输入 6 美元、写入 7.50 美元、读取 0.60 美元。
- 地域与平台有溢价:指定美国境内推理、或走部分云平台,价格会带额外倍率,算账前先确认自己用的是哪一档。
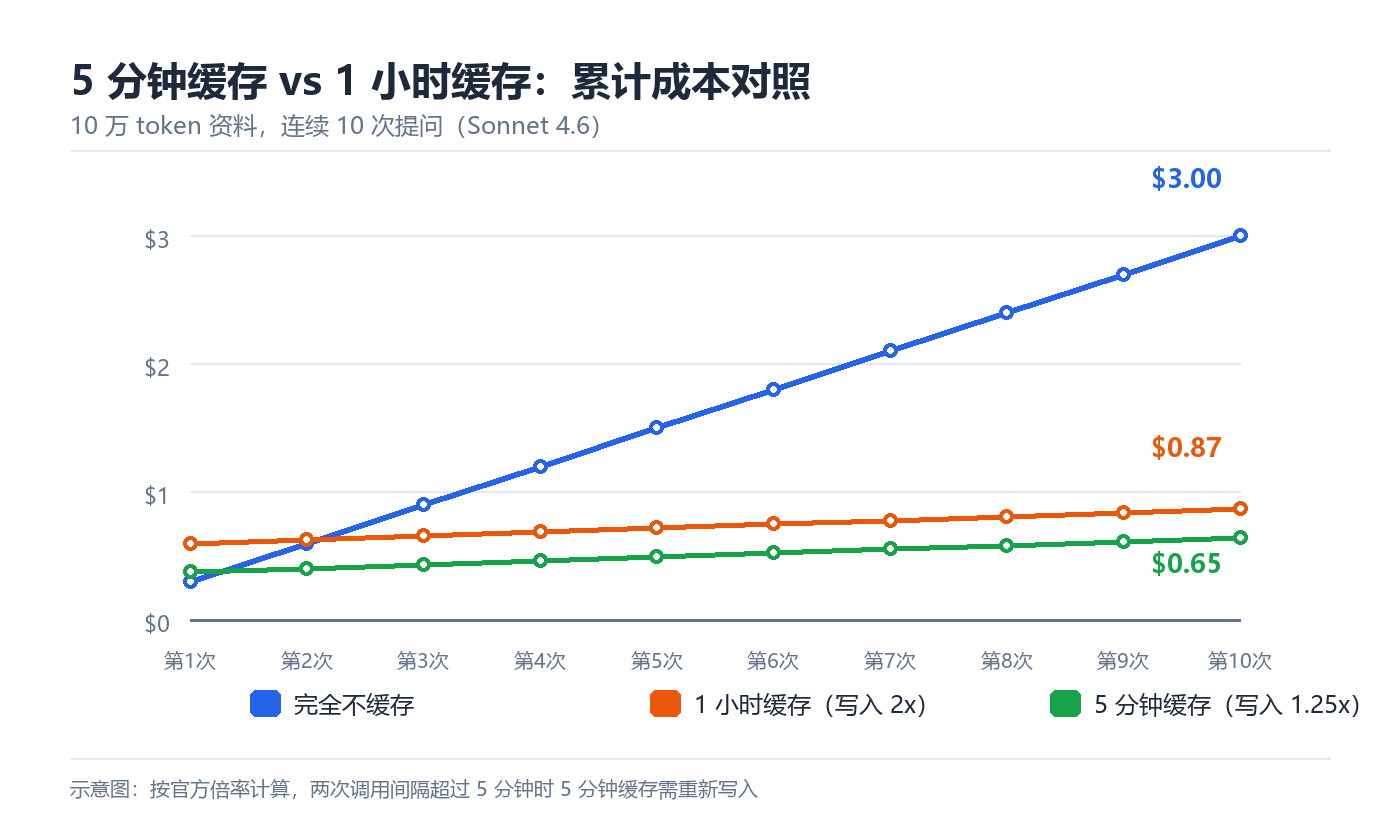
图 6:提问越密集,5 分钟缓存越划算;间隔长才需要考虑 1 小时缓存。示意图,按官方倍率计算。
常见问题
Q1:怎么确认这次请求命中了缓存?
A:看响应 usage 里的 cache_read_input_tokens,大于 0 就是命中了;cache_creation_input_tokens 大于 0 表示这次是写入;两个都为 0 说明没缓存上。
Q2:为什么我明明加了 cache_control 还是没命中?
A:三个高频原因——内容没到最小缓存长度、前缀里混进了每轮都变的内容(比如时间戳)、两次请求间隔超过了 TTL。
Q3:1 小时缓存值得开吗?
A:写入是 2 倍价,需要至少两次读取才能和不缓存打平;只在两次调用间隔经常超过 5 分钟的场景才划算。
Q4:多轮对话越聊越贵,是缓存失效了吗?
A:多数情况是断点被对话推远了。官方的自动回溯只能覆盖约 20 个内容块,长对话要主动在靠后的位置补一个断点。
Q5:缓存会不会影响回答质量?
A:不会。缓存的是计算中间结果,复用的是同一份 KV,模型看到的输入内容并没有变化。
写在最后
AI 账单上的差距,很多时候不是「谁用的模型更便宜」,而是「谁把同样的内容少算了几遍」。把系统提示词和工具定义固定住、把变化内容往后挪、把断点打对位置、再把 usage 字段盯起来——这四件事做完,多轮问答和 Agent 任务的输入成本通常会立刻掉一个数量级。价格会随模型和平台调整,动手前建议先核一遍官方文档里的当期定价。
更新时间:2026-10-13 | 作者:白马号