
两天之内,两家云厂商从同一层动手。亚马逊先开源 TorchNeuron,让 PyTorch 代码切到 neuron 设备就能跑在 Trainium2 与 Trainium3 上;第二天谷歌云在 PyTorch Conference 2026 上宣布 TorchTPU 开源,TPU 成为 PyTorch 的原生后端。TorchTPU 官方技术说明给的路径很直接:改一处配置,现有代码不用重写。
这件事的分量不在两款产品本身,而在于那句被反复引用的数字:PyTorch 覆盖约 85% 的 AI 应用代码。谁能让这 85% 的代码在自己的芯片上跑起来,谁就少了一道迁移的墙。
两家动的是同一层
过去几年,云厂商自研芯片的短板从来不在峰值算力,在软件。模型代码写在 PyTorch 里,算子、调试器、编译链路却围着一种硬件长出来,换芯片等于换一套工作流。
两家这次选的位置完全一致:不动框架本身,动的是框架与硬件之间的那一层。把这一层做成可插拔的,芯片就只是被 device_map 或 .to() 指向的目标。两天内先后落地同一件事,说明这不是单点产品发布,而是结构性调整——硬件开始主动把自己塞进主流框架的接口里,而不是等框架来适配自己。
迁移成本被压到一行代码
两侧的迁移动作都是一句话能说完的:
- 谷歌侧:Hugging Face Transformers v5 部署 TPU 只需传
device_map="tpu" - 亚马逊侧:PyTorch 代码切到
.to('neuron')就能在 Trainium2 与 Trainium3 上运行
此前 PyTorch 的功能几乎都是围绕英伟达 GPU 打造,一次硬件更换往往意味着重写脚本、重调算子、重建调试流程。迁移成本从重写降到一行配置,这才是这件事真正的卖点,而不是某块芯片的浮点性能。
亚马逊原生 PyTorch 支持公告把这份支持写得很具体:按 Apache 2.0 开源,支持 eager 执行、torch.compile 与 NKI 自定义算子。
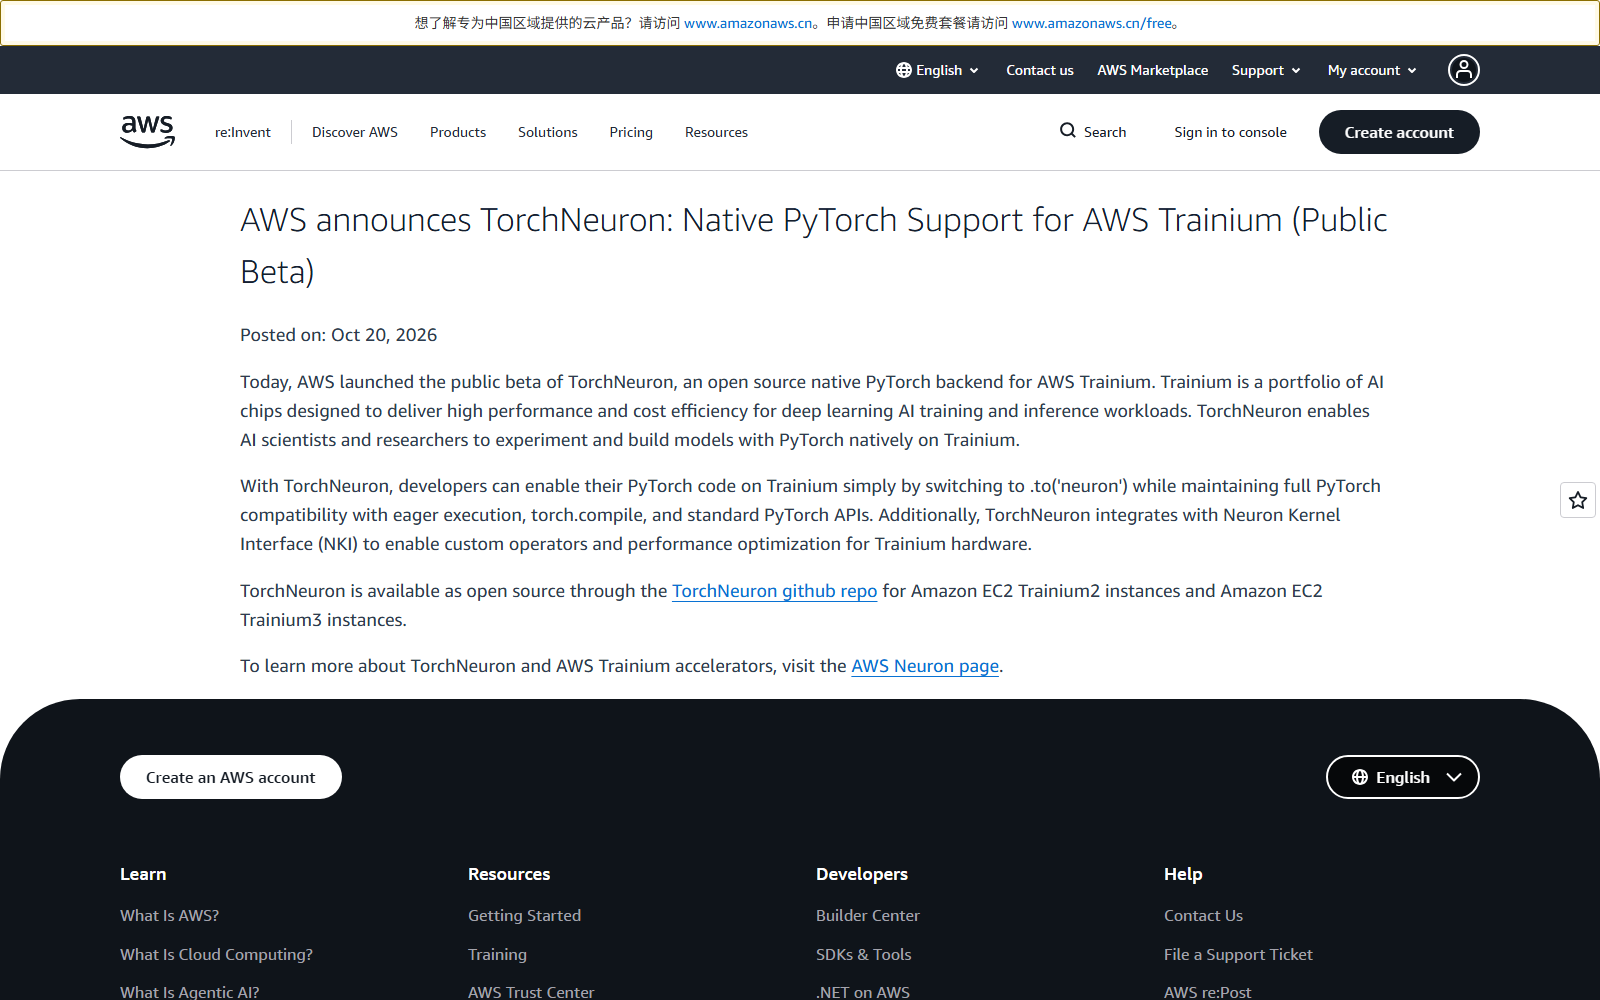
图 1:PyTorch 代码只需切到 .to('neuron') 即可在 Trainium 上运行
谷歌这一侧给的是整套后端
谷歌的力度明显更大。TorchTPU 不是闭门做出来的,而是与 Meta 的 PyTorch 团队共同开发,支持 eager 调试与 torch.compile 生产编译——前者对应「出问题时能断点看」,后者对应「上线时能编译优化」,缺一项开发者都不认。
配套动作也齐:
- 同步落地 vLLM(与 Inferact 合作)与 SGLang(与 RadixArk 合作)的 TPU 后端
- 预览 TPU agent suite
- 让端侧推理工具 LiteRT 接入 PyTorch 生态
- 同场发布 Kubernetes 原生分布式推理栈 llm-d 1.0
这套组合的意义在于覆盖了推理链路的全段:训练侧有编译器,服务侧有 vLLM 与 SGLang,端侧有 LiteRT。把生态位一圈补满才是真投入,开源一个后端反倒是最容易的那一步。
亚马逊主动披露了没做完的部分
相比之下,亚马逊给出的数字更值得读,因为它是负面的。AWS 自陈 PyTorch 官方测试约 15.4 万项结果里,约 6.9 万项被跳过,其中约 2.2 万项是因为缺少 Trainium 原生算子;稀疏张量、嵌套张量、动态形状都没有纳入首版。一家厂商主动公布「我们的测试有四成多没跑通」,这比任何性能宣传都有信息量,它同时划出了边界:现在能迁的是常规稠密负载,稀疏与动态形状还得等算子补齐。
客户侧的进展是另一面:首批已有 30 多家客户,Hugging Face 在 Transformers 与 Diffusers 里把 Trainium 列为支持设备,Meta 的 PyTorch 团队也公开背书。
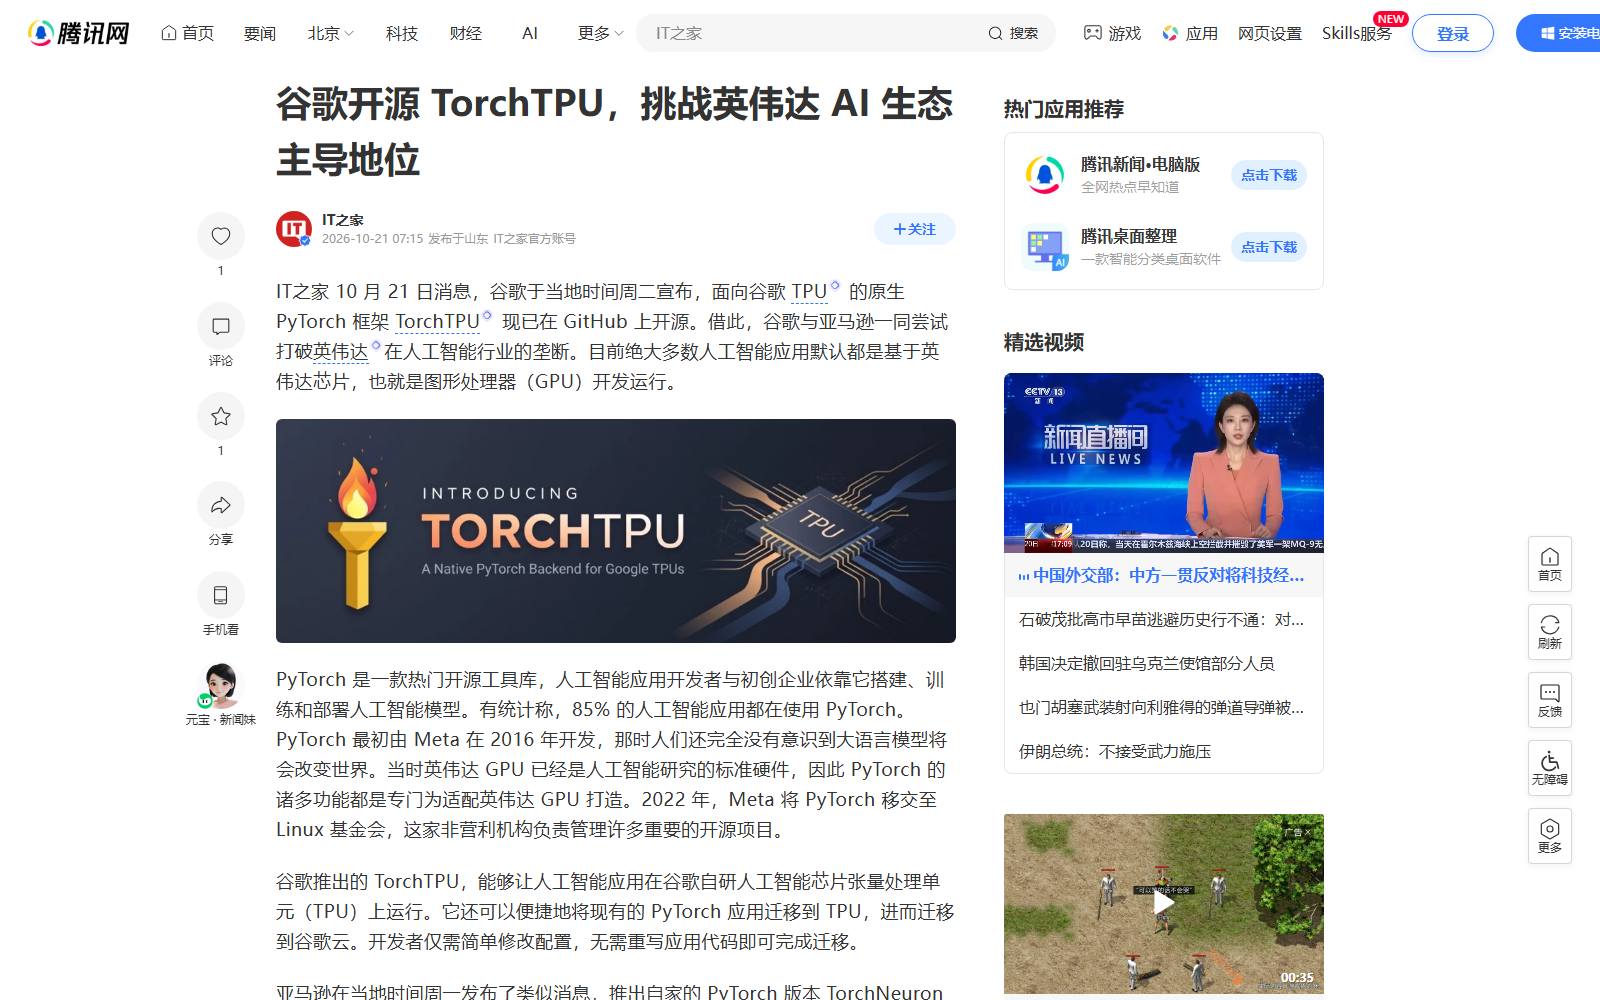
图 2:TorchTPU 与 Meta 的 PyTorch 团队共同开发
上游那层改动才是长期变量
亚马逊同时向 PyTorch 上游提交了解耦硬件相关代码的改动。这一条最容易漏,但影响最长。一旦这层抽象被合并进主干,变化的不只是一家厂商:
- 受益方从 Trainium 扩到所有实现同一套接口的硬件
- 适配工作从各家私有分支搬回所有人共用的主干
- 采购方的比较口径从单卡算力转向真实迁移代价
第三点对买家最实用。把适配搬回上游才是实质改动,因为它决定了一次比价的成本有多低。OpenAI 与 Cerebras 的算力订单说明头部买家已经愿意为特定负载单独下注,中兴 AI 一体机与算力营收说明交付形态正从卖卡转向卖整机,两条线指向同一个结论:机器的价值越来越取决于软件栈能接住多少现成代码。
客户数字要看清口径
Deepgram 的说法是,同样的钱在 Trainium 上处理的音频秒数比原 GPU 基线多约 60%。
这个数字要标注口径。它是厂商口径,且没有披露对比的是哪一款 GPU。真要拿它做决策,至少得先问清三件事:
- 对比的是哪一款 GPU,显存与带宽在哪个档位
- 基线那一侧的软件栈版本与调优程度是否对等
- 音频处理链路的批大小与并发,在实际业务里能不能复现
未披露对比基准的倍数只能当方向参考,不能当采购依据。这不是说它不可信,而是说它无法被第三方复现。本土大模型与芯片产能这条线可以放在一起看:模型侧的开源节奏越快,推理侧能选硬件的余地就越大,而软件层的迁移成本直接决定了这份余地能不能兑现。
个人观点
两家同时动手,最直接的变化是「换芯片」这件事的成本结构变了。
- 短期看迁移:一行配置就能跑,试错成本低到可以随手验证
- 中期看算子:稀疏张量、嵌套张量、动态形状补齐之前,能迁的只是一部分负载
- 长期看上游:解耦代码进了主干,竞争才真正回到硬件本身
真正该记住的不是谁先发布,而是两家都选择在框架层而不是驱动层动手。框架层的改动一旦被合并,壁垒就从「代码只能在我这跑」变成「代码在谁那都能跑」——对写代码的人是好事,对靠不兼容吃饭的人是坏事。
更新时间:2026-10-21