
2026 年 10 月 15 日,Meta 发布 Muse Spark Open 并开放权重,自称迄今最强的美国开放权重模型。架构是 MoE 混合专家:总参数 816B,每 token 激活 42B;62 层,隐层维度 8192,每层 256 个专家,路由每 token 选 8 个。上下文 1,048,576 tokens,即 100 万,原生多模态输入覆盖文本、图像、视频、音频,输出为文本。按 Meta 的说法,这一版是给开发者自己部署、自己微调用的底座,前沿能力留在三天前发布的闭源旗舰里。
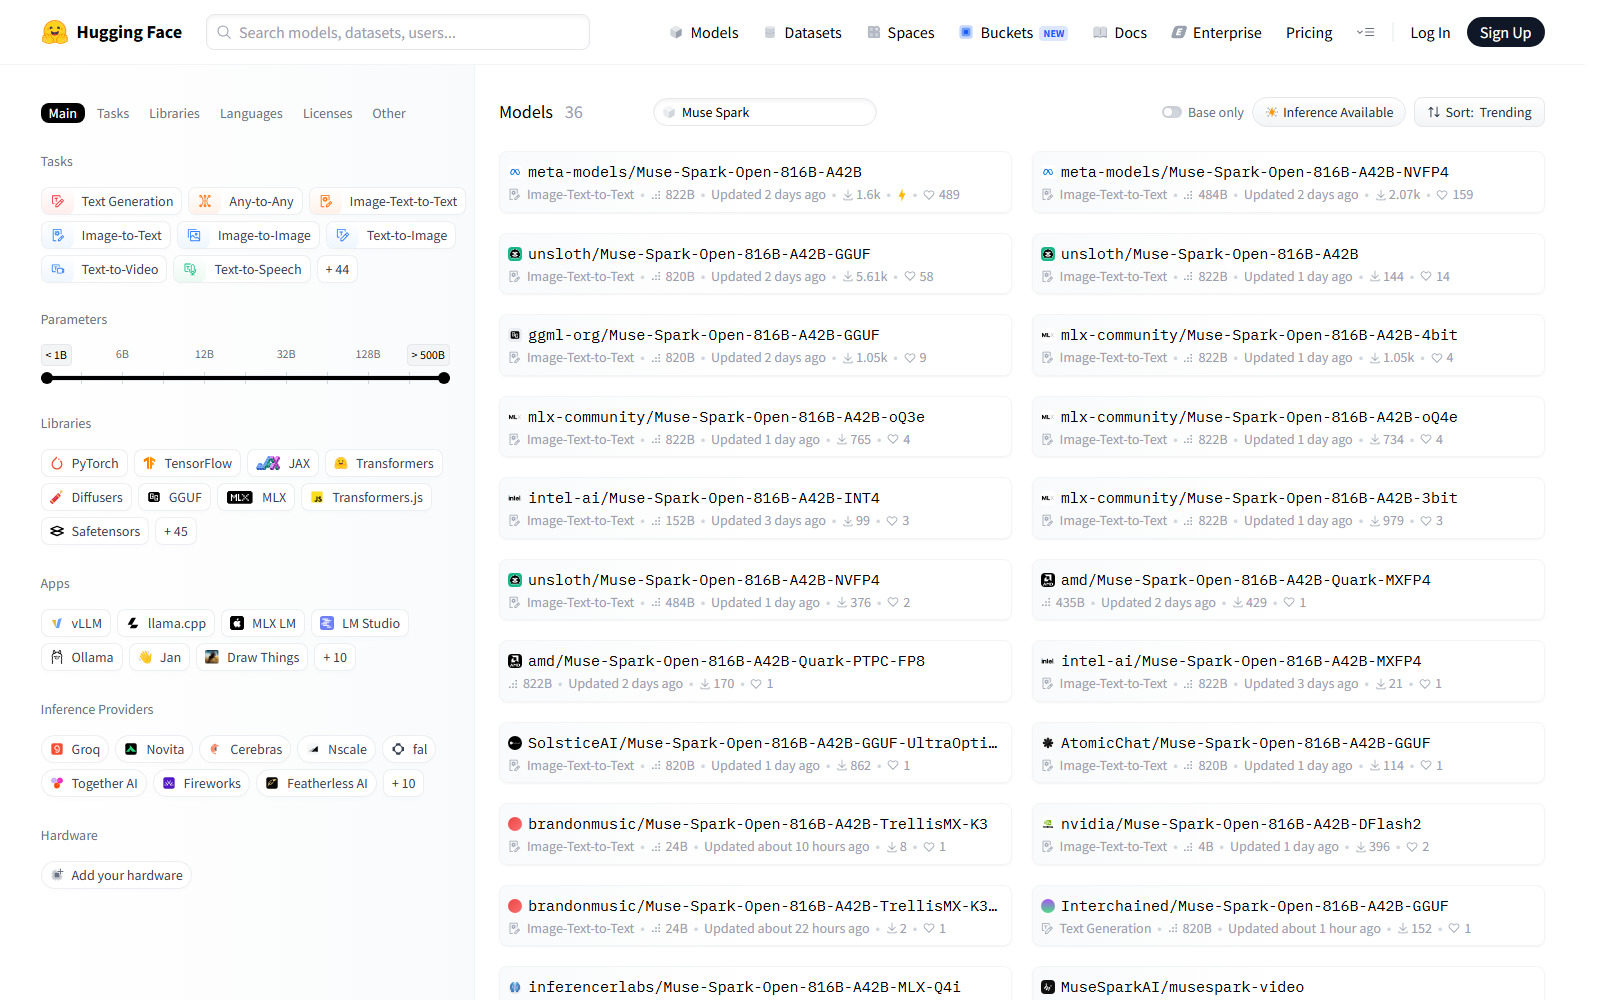
图 1:Meta 在 Hugging Face 放出的 Muse Spark Open 权重仓库
事件经过
这一版与闭源轻量模型 Muse Spark 1.3 共用基座,本次开放的是 8 月 Muse Spark 基座的 checkpoint,并做了额外的安全后训练。它含 1.8B 感知编码器,推理常开,四档思考强度为 low / medium / high / xhigh。
这是 Meta 自 2025 年 4 月 Llama 4 以来首次重大开放发布,距其 10 月 12 日发布闭源旗舰 Muse Wonder / Muse Wonder Full 只隔三天。权重上架 Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry,推理引擎覆盖 SGLang、vLLM、TensorRT-LLM、MLX 等主流方案,并支持 PyTorch TorchTitan 微调。
许可证采用 Meta 自研的 Muse Model License,不是 OSI 认证的开源协议,其中几条限制与商用直接挂钩。模型卡同时给出四项基准与 Kimi K3、GLM 5.3 的对比,全部为 Meta 自测,这决定了后面所有排名的性质。
「最强」前面的定语是「美国」
Meta 自测数据里,MCP-Atlas(MCP 工具调用)Muse Spark Open 得 89.2,Kimi K3 是 82.3,GLM 5.3 是 84.2;JobBench(办公任务)61.8,对手是 54.3 和 61.4。这两项它领先。
但换成写代码的场子就翻了过来:Terminal-Bench 2.1 上它是 76.4,Kimi K3 是 85.0,GLM 5.3 是 83.9;DeepSWE 1.1 上它是 60,对手是 68 和 67。综合口径的 Artificial Analysis 智能指数,它是 38.9 到 39,Kimi K3 是 43.6 到 44,GLM 5.3 是 44.8 到 45。
这几个基准测的不是同一种能力。MCP-Atlas 测的是调用外部工具完成多步任务,JobBench 测的是办公场景里的实际操作,Terminal-Bench 和 DeepSWE 测的是在终端与代码库里动手术。前两项它赢,后两项它输,这个分裂不是偶然,而是训练目标的直接投影。
需要说清楚的是,这些数字全部为 Meta 自测,未经独立验证。所以最强限定在美国之内是准确的:对比美国其他开放权重模型,它比 Thinking Machines Inkling 的 26、NVIDIA Nemotron 3 Ultra 的 23 提升明显;但放到全球开放权重阵营,它排不到第一。更能说明定位的是另一个数字:Meta 自家闭源 Muse Spark 1.3 在同一智能指数上是 61,开放的这个版本,是家族里较弱的一档。
816B 里只有 42B 在干活
MoE 的关键在于总参数和激活参数是两回事。816B 里约 97% 的参数住在 256 个专家中,每个 token 只被路由到 8 个专家,所以实际算力开销按 42B 算,而不是按 816B 算。这是这个体量的模型还能被认真讨论跑起来的原因,也直接解释了它的 API 定价:百万输入 token 1.25 美元,百万输出 token 4.25 美元,缓存读取 0.15 美元,Baseten、Fireworks、Groq、Modal、Nebius、OpenRouter、Together 同价。
100 万 token 的上下文配上常开的推理,意味着长任务的成本主要由缓存读取决定,这也是缓存读取被单独标价 0.15 美元的原因。
工程侧还有一层账:SGLang 中的 Helion GPU kernel 在 NVIDIA 与 AMD 上带来 1.03 到 3.95 倍的 kernel 级加速,AMD MI350 端到端提速 3%。安全维度是它少见的强项:StrongREJECT v2 抗越狱得分 0.5,越低越好,同表其他开源模型为 63 到 86;AA Omniscience 惩罚自信瞎猜,得分 25,为对比中最好。能力不是最强、但更听话,这个组合指向的用途很清楚。
开源不等于免费
把权重下载下来只是第一步。BF16 全量权重约 1.5 到 1.6TB,NVFP4 4bit 量化版仍需至少 700GB 显存。想在自己的机器上跑,Meta 与 Apple 合作,通过 MLX 框架可以在两台 M5 Ultra Mac Studio(各 512GB 统一内存)上运行,两台机器表现为约 1TB 统一内存的单机,芯片内存带宽 1.2TB/s。有媒体估算两台 512GB Mac Studio 约 2.2 万美元,另有 4×256GB 方案约 3.8 万美元的说法;Apple 尚未公布 512GB 版本定价,预计 10 月下旬上市。
许可证明面上的限制更具体:产品中需标注 Built with Muse Spark Open;年 API 收入超过 2000 万美元,需要与 Meta 另签协议。前者对做海外产品的团队意味着让渡一部分品牌表达,后者是一条清清楚楚的商业化分界。所以它更适合需要自己握权重做微调的公司,而不是想省钱的小团队。
图 2:Muse Spark Open 的参数量、上下文与许可证条款解读
700GB 显存这条线也把大多数团队挡在本地部署之外,常见做法是租算力而不是买机器。这套方案更像一次能力演示:证明这个体量的模型能在桌面级内存里跑起来,不是一个采购建议。
个人观点
开放权重在 2026 年已经变成一种产品定位,而不是一种立场。Meta 三天内先发闭源旗舰、再开一个较弱档的权重,形成闭源打前沿、开源留开发者的双轨:它给开发者的不是最强模型,而是一个够用、可微调、能把权重握在自己手里的选项。这个策略换到的是开发者,代价是最强的定语越缩越小,缩到必须在前面加美国。
第二点更值得国内团队注意。这份榜单的真正含义是,开放权重赛道的第一梯队已经在中文模型这边。工具调用输、写代码输、综合智能指数输,Meta 赢的是办公任务和安全对齐。它押的是办公智能体,不是 AI 程序员。如果代码能力是你的主战场,这个模型不构成威胁。
第三,开源的成本正在从下载免费变成部署起步价两万美元。真正决定一个开放权重模型能不能被用起来的,从来不是权重文件本身,而是许可证条款和显存门槛。这两项 Meta 都没放松:品牌标注是营销资产,营收门槛是商业边界,700GB 显存是物理边界。所谓开放,开放的是权重,不是成本。
最后一句提醒:所有基准都是自测。等第三方把 MCP-Atlas 和 JobBench 重跑一遍,这张表可能还要改。在那之前,最强是个待验证的说法,不是结论。
更新时间:2026-10-18